Partie 3 : L’IA peut-elle extraire avec précision les données d’urbanisme des règlements de zonage?
Dans la première partie de cette série de trois billets de blogue consacrée à la question de savoir si l’IA peut extraire avec précision des données d’urbanisme à partir des règlements de zonage, Jocelyn Tang, analyste SIG à Esri Canada, présentait le problème et examinait différents grands modèles de langage (GML) afin de trouver celui le mieux adapté à cette tâche. Dans la deuxième partie, elle examinait différentes mesures d’évaluation des GML. Elle concluait que l’utilisation des GML pour extraire de l’information des règlements de zonage permet d’atteindre une précision d’environ 70 %. Dans ce dernier volet de la série, elle termine son étude en affinant l’un des modèles utilisés dans la deuxième partie afin de déterminer si cette approche permet d’améliorer les résultats.
Les modèles encodeur seulement nécessitent un affinage plus poussé et propre au domaine pour améliorer leur précision. Dans la troisième partie de cette série de billets de blogue, je souhaite déterminer si l’affinage à partir de textes de règlements de zonage permet d’améliorer le score F1 de RoBERTa (Robustly Optimized BERT Approach), le modèle de question-réponse préentraîné qui s’est révélé le plus performant dans la deuxième partie.
Affinage et préentraînement
On pourrait facilement croire qu’il n’existe qu’une seule façon d’entraîner les modèles d’IA. En fait, les méthodes d’entraînement sont nombreuses. Il est important de bien comprendre la différence entre l’affinage d’un modèle et le préentraînement à partir de zéro d’un modèle de base ou d’un modèle fondamental.
Préentraînement : Il s’agit de la phase initiale de l’entraînement d’un GML, au cours de laquelle le modèle ne possède encore aucune connaissance préalable. L’objectif du préentraînement est de créer un modèle fondamental capable de comprendre le langage en général (par exemple, GPT, Claude, RoBERTa ou BERT). Le GML est entraîné sur un vaste ensemble de données diversifié (souvent constitué de milliards, voire de milliers de milliards, de jetons provenant d’Internet, de livres et de code) afin d’acquérir une compréhension étendue de la langue, du contexte et de divers types de connaissances. Ce processus est très exigeant sur le plan informatique et requiert d’énormes volumes de données.
Affinage : L’affinage consiste à poursuivre l’entraînement d’un modèle de base déjà préentraîné à partir d’un ensemble de données plus spécialisé. Les ensembles de données utilisés pour l’affinage sont souvent propres à un domaine. Le modèle affiné peut ainsi obtenir de meilleurs résultats pour des tâches ou des scénarios spécialisés qui étaient peu représentés lors du préentraînement, par exemple l’établissement de diagnostics médicaux ou l’analyse de certains textes ou documents juridiques. L’affinage vise à approfondir les connaissances d’un modèle existant dans des contextes précis plutôt qu’à élargir ses connaissances générales. Cette méthode est moins exigeante sur le plan informatique et nécessite un ensemble de données beaucoup plus restreint que celui utilisé pour le préentraînement.
Les règlements de zonage constituent un ensemble de données propre à un domaine. Dans ce cas-ci, il est donc logique d’affiner un modèle préentraîné existant.
Pour en savoir plus sur ce sujet, consultez l’article Qu’est-ce que le réglage fin? d’IBM.
Méthodes d’affinage
Il existe de nombreuses façons d’affiner un modèle. Dans ce billet de blogue, je n’aborderai que quelques méthodes principales.
Affinage supervisé (SFT) : Il s’agit de la méthode d’affinage la plus simple et elle convient particulièrement aux tâches bien définies. Elle repose sur un ensemble de données constitué de paires d’entrées et de sorties. Le modèle traite les données d’entrée et produit les sorties souhaitées, comme des étiquettes de classification ou la suite d’une invite. La préparation de l’ensemble de données est essentielle.
Affinage économe en paramètres (PEFT) : L’un des principaux défis liés à l’affinage des GML tient à leur taille. En temps normal, l’affinage réentraîne tous les paramètres du modèle. Avec la méthode PEFT, seule une petite partie des paramètres du modèle est affinée. Les besoins en ressources s’en trouvent considérablement réduits. (DigitalOcean est un exemple d’outil qui fournit l’infrastructure nécessaire pour affiner un GML.)
Pour affiner un modèle RoBERTa de question-réponse préentraîné à partir des données des règlements de zonage, j’ai opté pour l’affinage supervisé.
Pour en savoir plus sur l’entraînement des GML, consultez la documentation d’IBM; pour en apprendre davantage sur l’affinage, consultez ce tutoriel de DigitalOcean.
Les courbes d’apprentissage, qu’est-ce que c’est?
Avant de procéder à l’affinage du modèle, il est important de bien comprendre les courbes d’apprentissage. Elles permettent d’évaluer la performance du modèle pendant l’entraînement et de repérer les problèmes potentiels avant qu’ils ne nuisent à sa performance.-
Les courbes de perte montrent comment l’erreur (perte) du modèle évolue au fil des étapes d’entraînement.
Les courbes de précision indiquent le pourcentage de prédictions correctes au fil des étapes d’entraînement.
Quant aux courbes de perte de validation, elles permettent d’évaluer la performance d’un modèle d’apprentissage profond sur un ensemble de données de validation, c’est-à-dire sur des données qu’il n’a jamais vues pendant l’entraînement.
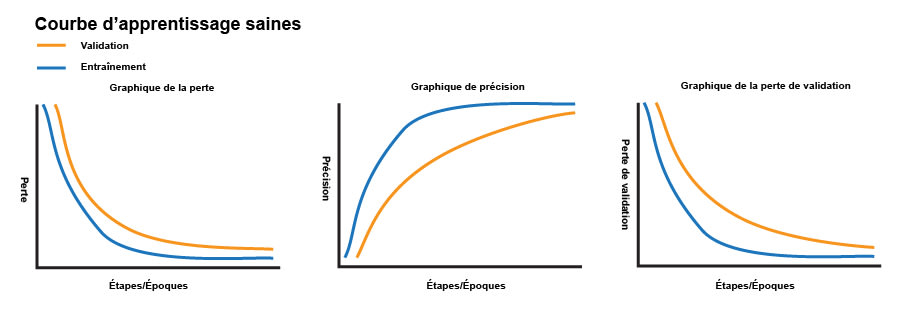
Exemples de courbes de perte, de précision et de perte de validation présentant une évolution normale.
Avant l’entraînement, la perte initiale du modèle devrait être élevée, puisque ses prédictions sont alors peu précises. À mesure que l’entraînement progresse, la perte devrait généralement diminuer. Elle finit par se stabiliser à une valeur faible une fois que le modèle a appris les régularités présentes dans les données.
Dans le cas des courbes de précision, la précision devrait être faible au départ, puis augmenter à mesure que l’entraînement progresse et que le modèle apprend les régularités présentes dans les données. Les courbes de précision peuvent présenter des plateaux à mesure que les prédictions du modèle se rapprochent de la réponse attendue.
Pour en savoir plus sur les courbes d’apprentissage, consultez le cours sur les GML de Hugging Face et la fiche de GeeksforGeeks sur les courbes de perte à l’entraînement et à la validation en apprentissage profond.
Préparation de l’ensemble de données d’entraînement
Comme nous l’avons mentionné précédemment, la préparation de l’ensemble de données est essentielle à l’affinage supervisé propre au domaine. Les ensembles de données doivent être nettoyés et formatés de façon à ce que le modèle puisse les exploiter. Pour plus d’information sur la préparation des ensembles de données, consultez la partie 2.
Dans le cadre de ce projet, j’ai mené deux expériences d’affinage à partir d’ensembles de données d’entraînement de 100 et de 500 exemples étiquetés.
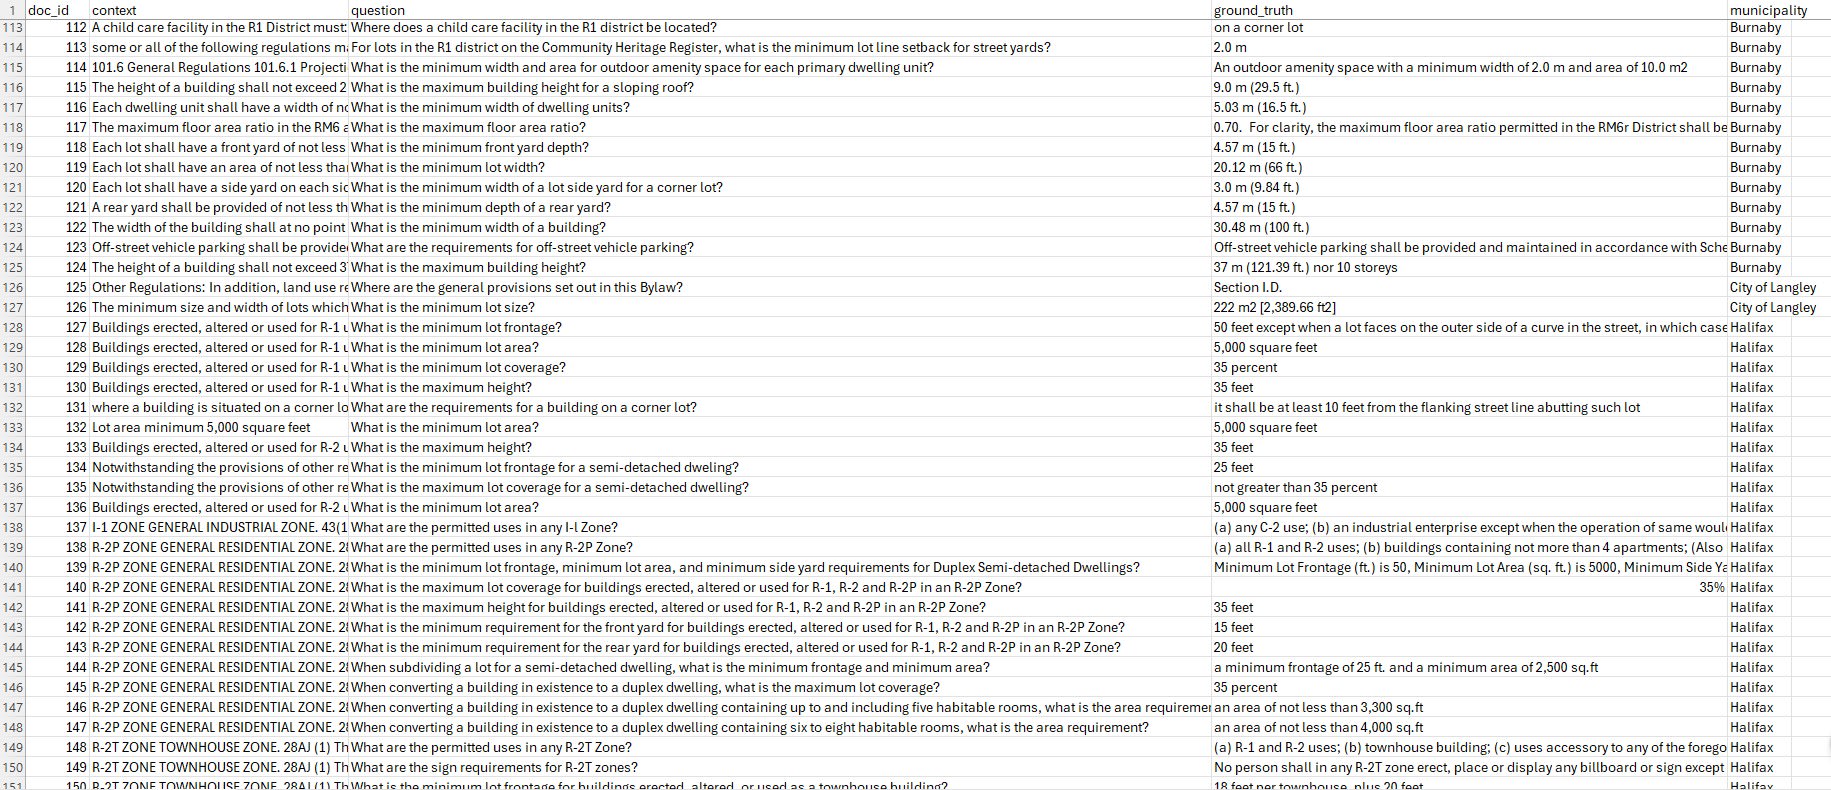
Capture d’écran d’un extrait de l’ensemble de données d’entraînement utilisé.
Quels ont été les résultats de l’affinage?
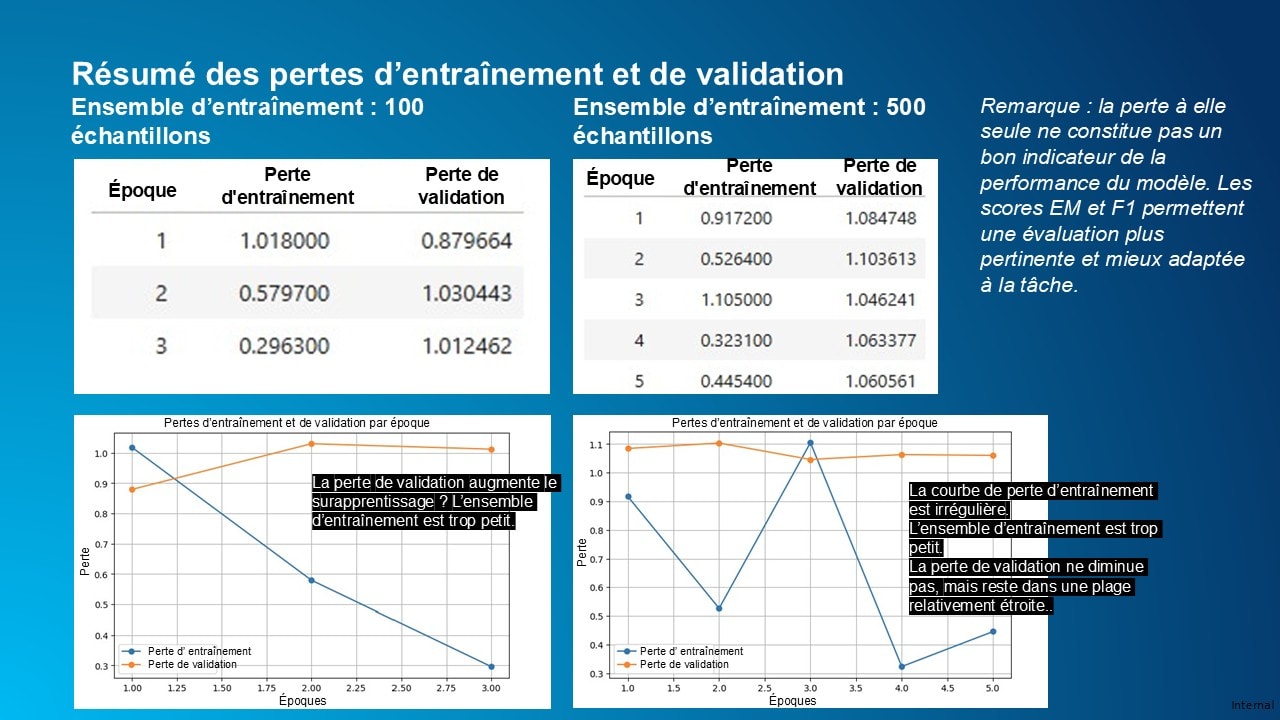
Vous trouverez ci-dessous une image présentant un résumé des pertes d’entraînement et de validation pour les expériences d’affinage réalisées avec les ensembles de données d’entraînement de 100 et de 500 échantillons.
Vous trouverez ci-dessous un tableau présentant les scores de correspondance exacte (EM) et F1 (pour connaître la signification de ces mesures, consultez la partie 2 de cette série de billets de blogue) obtenus lors des expériences d’affinage réalisées avec les ensembles de données d’entraînement de 100 et de 500 échantillons.
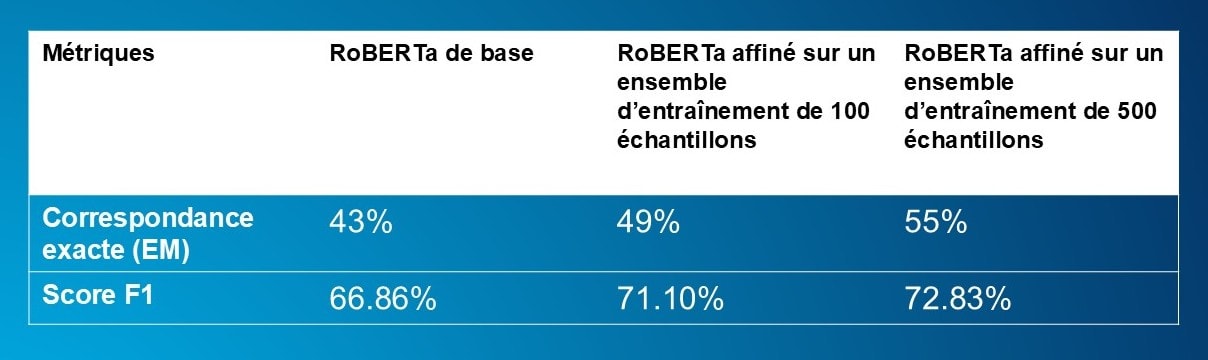
Remarque : La perte à elle seule n’est pas un bon indicateur de la performance du modèle. Les scores EM et F1 permettent une évaluation plus ciblée et plus pertinente.
Lorsque je me suis renseignée sur les courbes d’apprentissage, j’ai notamment constaté que les tutoriels présentent aux apprenants des exemples idéaux. En réalité, les valeurs de perte d’entraînement et de validation présentent souvent des fluctuations, surtout lorsque les ensembles de données d’entraînement sont de petite taille. Ne soyez pas surpris, lors de vos premières expériences, de constater qu’il est difficile d’interpréter les graphiques et les chiffres.
Dans les deux expériences, la perte d’entraînement diminue généralement à un rythme stable, à l’exception d’une fluctuation aléatoire et d’une augmentation observées à la troisième époque de l’expérience portant sur 500 échantillons. Cependant, la perte de validation augmente dans l’expérience portant sur 100 échantillons et diminue très peu dans celle portant sur 500 échantillons. Elle reste donc essentiellement dans la même plage. Cela pourrait s’expliquer par la petite taille de l’ensemble de données d’entraînement.
J’ai ainsi constaté que la perte à elle seule n’est pas un bon indicateur de la performance du modèle et que, particulièrement pour les tâches de question-réponse, les scores EM et F1 permettent une évaluation plus pertinente. Je me suis donc plutôt concentrée sur ces mesures.
Par rapport au modèle de base, l’affinage à partir de l’ensemble de données d’entraînement de 100 échantillons donne de bons résultats : le score EM augmente de 12 points et le score F1, d’environ 6 points. Cependant, avec l’ensemble de données d’entraînement de 500 échantillons, les gains supplémentaires ne sont que d’environ un point pour les scores EM et F1. L’augmentation de la taille de l’ensemble de données d’entraînement, de 100 à 500 échantillons, s’accompagne donc de rendements décroissants.
Il semble également qu’après l’affinage, les modèles aient encore du mal à répondre à des questions complexes et ne soient pas en mesure de fournir des réponses comportant de nombreux énoncés conditionnels ou de longues phrases. Vous trouverez ci-dessous une capture d’écran de certaines réponses fournies par le modèle lors de l’évaluation après l’entraînement :
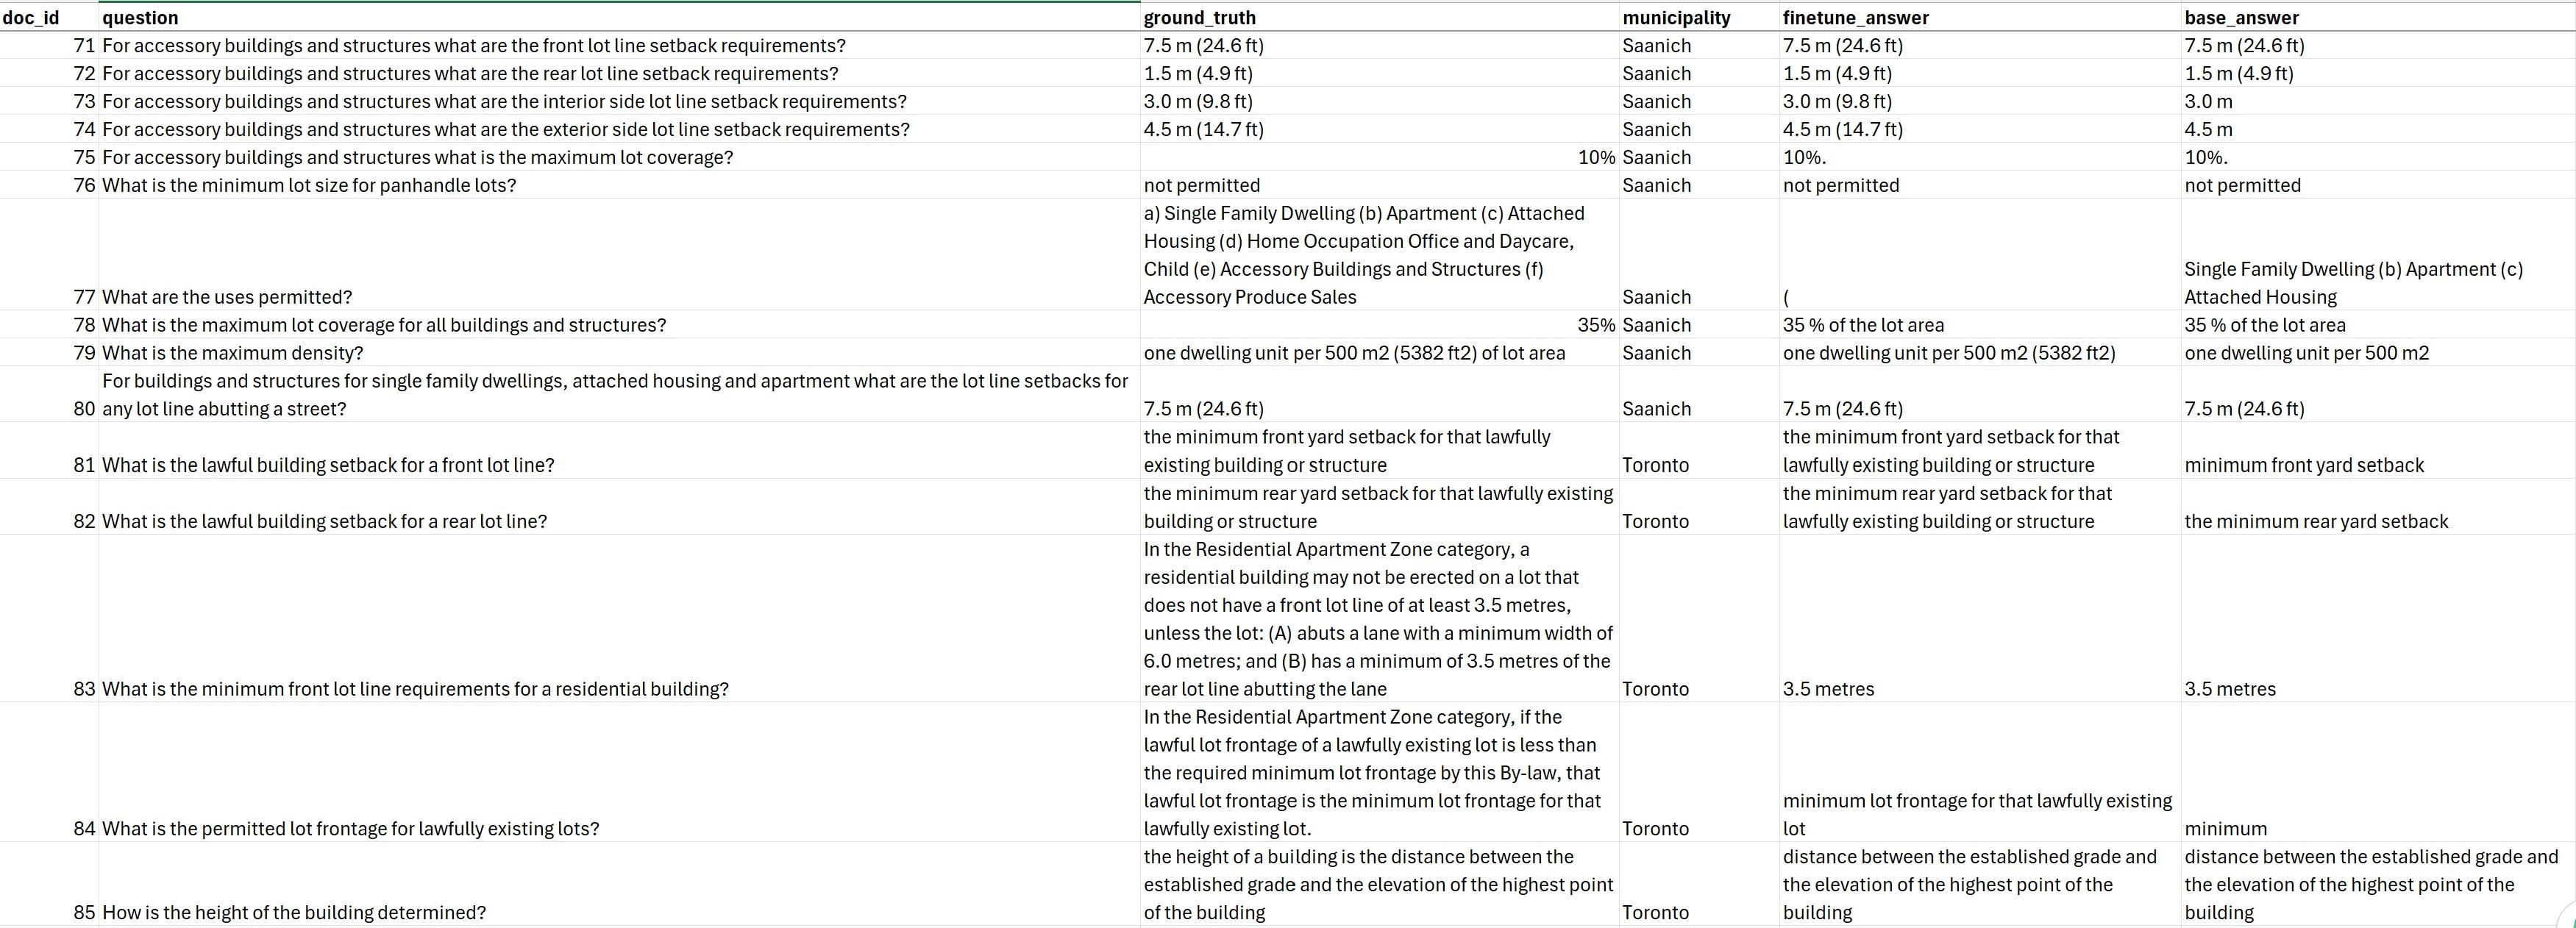
Une capture d’écran de certaines réponses fournies par le modèle lors de l’évaluation après l’entraînement.
Plusieurs facteurs pourraient expliquer ces rendements décroissants :
- La majeure partie des gains a été obtenue à partir de 100 à 200 exemples de l’ensemble de données d’entraînement.
- Le domaine est peut-être trop semblable à ceux auxquels le modèle a déjà été exposé pour que l’affinage soit la méthode la plus efficace.
- L’ensemble de données n’est pas assez volumineux par rapport à la taille du modèle (ce qui explique le tracé très irrégulier de la courbe de perte d’entraînement).
- Un ensemble de données plus diversifié ou plus complexe, comprenant davantage de questions ambiguës ou difficiles à interpréter, donnerait peut-être de meilleurs résultats (ce qui est peu probable, puisque j’ai veillé à inclure une bonne variété de questions et de réponses faciles et difficiles).
- Le choix des arguments ou des hyperparamètres d’entraînement n’est peut-être pas optimal.
If you’re interested in looking at the source code and workflow, check out the Github repository for this project.
Réflexions finales
Je crois que les gains de précision diminuent parce que l’ensemble de données n’est pas assez volumineux par rapport à la taille du modèle. Pour améliorer encore la précision, j’aurais probablement besoin d’un ensemble de données comprenant plus de 10 000 exemples, au lieu des 500 actuels.
Dans l’ensemble, je considère ce projet comme une réussite : même si je n’ai pas obtenu les résultats idéaux, j’ai beaucoup appris en cours de route. Comme je l’indiquais dans la première partie, cette série de billets de blogue vise à faire connaître mon parcours d’apprentissage en présentant des concepts techniques de manière simple et accessible.
Enfin, il est important de garder à l’esprit la raison d’être de l’urbanisme : créer des collectivités où chacun peut s’épanouir. Un urbanisme de qualité contribue à créer un sentiment d’appartenance et d’attachement au lieu. Il faut trouver un équilibre entre des facteurs concrets, comme l’utilisation du sol, le transport et les infrastructures, et des considérations plus difficiles à quantifier, comme la culture, l’identité, l’équité et les valeurs de la collectivité. Pour y parvenir, il faut faire preuve d’empathie et de jugement et posséder une connaissance du milieu. Comme je l’ai montré dans cette troisième partie, le modèle n’est pas encore prêt à fonctionner sans une intervention humaine considérable. Il faut donc faire preuve de prudence lorsqu’on utilise des GML pour traiter des données de zonage et toujours vérifier les résultats obtenus.
En général, lorsqu’on utilise des outils d’IA…
- Il faut porter un regard critique sur leurs résultats.
- Il faut tenir compte des biais ainsi que de la qualité de leurs données d’entraînement et de leurs algorithmes.
- Il faut comprendre les forces et les limites des différents outils d’IA et types de modèles.
- Il faut évaluer continuellement la précision de ces technologies afin de s’assurer qu’elles contribuent à l’atteinte des résultats souhaités, particulièrement dans le cadre de tâches et de processus décisionnels à haut risque.
Il
Poursuivez la discussion en vous joignant à notre groupe LinkedIn.
Ce billet a été écrit en anglais par Jocelyn Tang et peut être consulté ici.